IA local en 2026: qué modelo y qué app usar según tu memoria, SO y dispositivo
La mejor IA local no es la que gana un leaderboard: es la que cabe en tu máquina, responde a una velocidad útil y mantiene tus datos donde tú decides. Esta guía permite elegir runtime y modelo por memoria disponible, sistema operativo y tarea, con comandos y límites comprobados.
La respuesta rápida
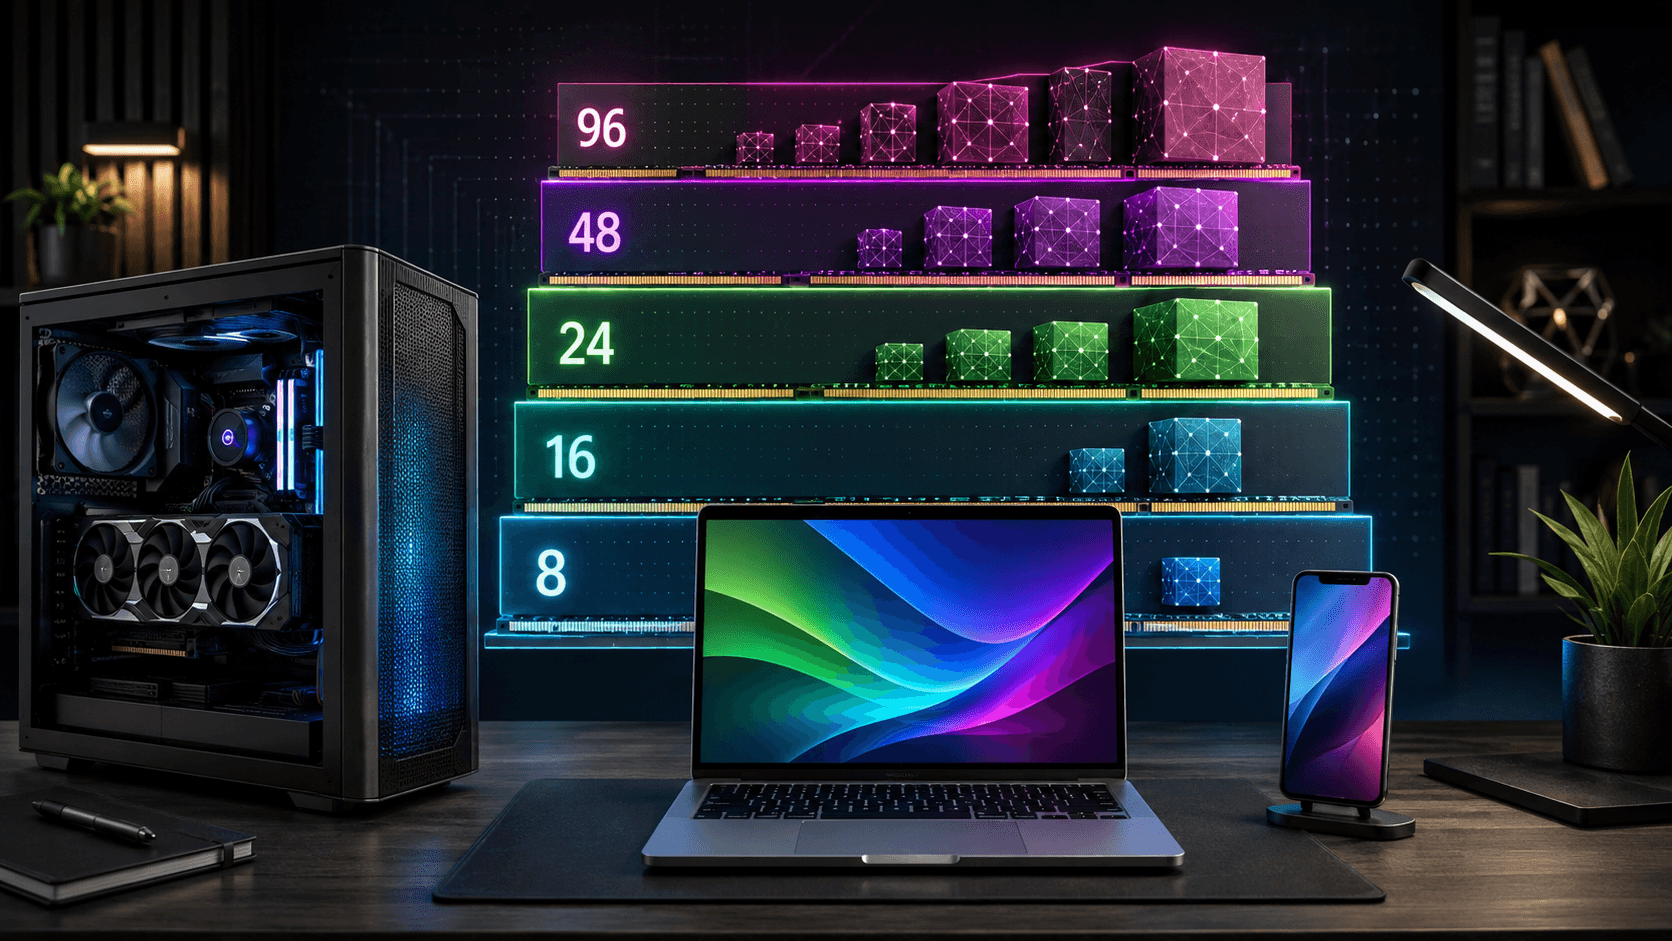
Empieza con Ollama si quieres una instalación sencilla y conectar otras aplicaciones, o con LM Studio si prefieres una interfaz gráfica. Con 8-12 GB elige modelos pequeños; con 16-24 GB puedes usar modelos de 12B y, en el límite superior, Qwen3.8-27B cuantizado; con 32-48 GB ganas calidad y contexto; los modelos de cientos de miles de millones de parámetros pertenecen a estaciones de trabajo o servidores.
- 8-12 GB: Gemma 4 E2B/E4B o modelos de 3B-7B.
- 16 GB: Gemma 4 12B y modelos similares con contexto moderado.
- 24 GB: Qwen3.8-27B Q4 puede caber, pero deja margen para contexto y sistema.
- 32-48 GB: Qwen3.8-27B Q8 o MoE cuantizados, según runtime.
- 96 GB o más: laboratorio self-hosted; no equivale a un portátil normal.
VRAM, memoria unificada, RAM y disco no son lo mismo
La VRAM de una GPU dedicada o la memoria unificada de Apple Silicon suele marcar el techo útil. Descargar capas a la RAM del sistema puede permitir cargar un modelo mayor, pero reduce mucho la velocidad. El disco solo determina si puedes guardar los pesos. La cuantización Q4, Q5 o Q8 reduce tamaño a costa de precisión; Q4_K_M suele ser un punto inicial razonable, no una garantía de calidad.
- Reserva memoria para el sistema, el runtime y la caché de contexto: no llenes el 100% con pesos.
- Un contexto anunciado de 256K o 1M puede necesitar mucha más memoria de la que sugiere el archivo del modelo.
- Mide tokens por segundo y calidad con tus documentos; el número de parámetros no decide por sí solo.
Qué app usar en Windows, macOS y Linux
En Windows, LM Studio y Ollama son las entradas más simples; vLLM o SGLang suelen resultar más cómodos bajo WSL2 o Linux para servir a varios usuarios. En Apple Silicon, compara Ollama con sus tags MLX y herramientas MLX nativas. En Linux, Ollama cubre uso personal, mientras llama.cpp ofrece control fino y vLLM o SGLang priorizan concurrencia y throughput.
- Ollama: CLI, API local y conexión sencilla con agentes.
- LM Studio: catálogo, cuantizaciones, chat y servidor desde una GUI.
- llama.cpp: control sobre contexto, capas, offload y formatos GGUF.
- MLX: ejecución optimizada para memoria unificada de Apple.
- Open WebUI: interfaz de chat sobre el runtime; no es el motor del modelo.
- vLLM/SGLang: servicio interno y varios usuarios, no la primera instalación doméstica.
Qué usar en Android, iPhone y iPad
Un móvil requiere modelos específicamente pequeños y runtimes adaptados. En Android, AI Edge Gallery, MLC Chat o PocketPal permiten probar modelos de pocos miles de millones de parámetros. En iPhone y iPad, las funciones on-device del sistema y aplicaciones especializadas son más realistas que copiar la receta de un PC. Un 3B-7B cuantizado puede servir para notas, clasificación o chat corto, pero no sustituye un agente de código largo.
- Comprueba memoria disponible real: el sistema y otras apps ya consumen una parte.
- Controla temperatura y batería durante pruebas largas.
- No asumas que una app móvil mantiene los datos offline: revisa su política y corta la red para comprobarlo.
8-12 GB: modelos pequeños y tareas acotadas
En este tramo prioriza resumen, redacción, clasificación, traducción y preguntas breves. La biblioteca de Ollama ofrece Gemma 4 E2B en unos 7,2 GB y E4B en unos 9,6 GB, ambos con entrada de texto e imagen. LFM2.5-2.6B y otros modelos de 3B-7B son candidatos razonables cuando velocidad y consumo importan más que razonamiento máximo.
- Empieza con un contexto corto y auméntalo solo cuando lo necesites.
- Para documentos, usa recuperación por fragmentos en lugar de pegar un libro entero.
- No evalúes un modelo pequeño con una refactorización de una hora: asigna tareas acordes al hardware.
16-24 GB: el tramo más útil para una sola máquina
Aquí la IA local pasa de experimento a herramienta diaria. Qwen3.8-27B aparece oficialmente en Ollama con un tag Q4_K_M de unos 18 GB y contexto de 256K. Puede caber en una GPU de 24 GB o un Mac con memoria suficiente, pero un contexto grande y otras aplicaciones consumen el margen restante. Gemma 4 12B ocupa unos 7,6 GB y deja mucho más espacio operativo.
- Descarga Qwen con: ollama pull qwen3.8:27b.
- Ejecútalo con: ollama run qwen3.8:27b.
- Muse Glimmer 30B ocupa unos 18 GB y está orientado a agentes locales multimodales.
- Nemotron 3.5 Lightning Q4 ocupa unos 25 GB: no es una recomendación limpia para una GPU de 24 GB sin offload.
32-48 GB: más calidad, contexto y concurrencia
Con este margen puedes usar Qwen3.8-27B en Q8, cuya ficha de Ollama ronda 30 GB, o aumentar contexto sin expulsar parte del modelo de la GPU. Qwen3.8-Flash-Next y DeepSeek V4 Flash son MoE mucho mayores: pocos parámetros activos no significan pocos pesos almacenados. Revisa el tamaño exacto de la cuantización antes de descargar.
- Elige Q5/Q8 si tus pruebas muestran una mejora que justifique memoria y latencia.
- Usa llama.cpp cuando necesites controlar offload y contexto con precisión.
- Usa vLLM o SGLang cuando el problema sea atender varias peticiones, no solo abrir un chat.
96 GB o más: estación de trabajo, no IA de portátil
GLM-5.3-Flash tiene 320B parámetros totales y 18B activos, mientras modelos como Kimi K3 son aún mayores. Que un MoE active una fracción de sus parámetros por token reduce cómputo, pero no elimina el almacenamiento y la memoria necesarios para sus pesos. En Ollama, GLM-5.3-Flash figura hoy únicamente como tag cloud alojado, por lo que no debe contarse como inferencia local.
- Revisa licencia, formato, tamaño completo y requisitos del runtime antes de descargar.
- Separa 'open-weight' de 'cabe en mi equipo': son propiedades distintas.
- Un tag con sufijo cloud envía la inferencia a infraestructura remota aunque se invoque desde Ollama.
NVIDIA PAIR reparte trabajo, pero no suma VRAM
NVIDIA PAIR, publicado en beta el 3 de septiembre, descubre equipos compatibles en una red local y envía cada solicitud independiente a un nodo disponible mediante interfaces compatibles con Ollama y OpenAI. Es útil para agentes con subagentes paralelos. No divide un modelo entre ordenadores ni combina varias GPU en una GPU virtual: cada solicitud completa se ejecuta en una sola máquina que debe poder cargar el modelo.
- Úsalo si ya tienes varios equipos y muchas solicitudes independientes.
- No lo compres como solución para cargar un modelo que no cabe en ningún nodo.
- Empareja solo dispositivos y redes de confianza; conserva controles de acceso y registro.
Tres stacks mínimos recomendados
Para chat privado, usa LM Studio u Ollama con un modelo que deje margen de memoria. Para uso diario tipo ChatGPT, añade Open WebUI. Para programar con privacidad, conecta OpenCode, Claude Code, Hermes u otro harness al endpoint local y exige diffs, tests y aprobación antes de escribir o ejecutar acciones sensibles.
- Chat privado: runtime + modelo; nada más.
- Asistente diario: Ollama + Open WebUI + un modelo rápido y otro de mayor calidad.
- Código: Ollama + Qwen3.8-27B o Muse Glimmer + agente con sandbox y pruebas.
- Empresa: servidor, autenticación, logs, copias, permisos por usuario y evaluación propia.
Qué evitar
No descargues un modelo de cientos de gigabytes por si acaso, no elijas por un benchmark sin medir tu hardware y no reduzcas a 2 bits para después juzgar la familia completa. Tampoco confundas privacidad con seguridad: un agente local con terminal y permisos amplios puede borrar archivos o ejecutar código peligroso sin enviar nada a la nube.
- No pegues nóminas, historiales o secretos en un servicio cloud para probar un flujo local.
- No abras un endpoint de Ollama a la red pública sin autenticación y aislamiento.
- No permitas acciones destructivas sin backup, Git o confirmación humana.
La prueba de 20 minutos
Instala un runtime, descarga un modelo con margen y ejecuta cuatro pruebas. Debe cargar sin bloquear el equipo, producir unas 200 palabras en un tiempo aceptable, responder sobre un archivo sin subirlo y usar GPU o Metal cuando el hardware lo permita. Si tarda minutos en una respuesta simple, baja de tamaño; si inventa datos del archivo, corrige el flujo de recuperación antes de cambiar de modelo.
- Comprueba consumo con ollama ps, nvidia-smi o el monitor de LM Studio.
- Prueba una tarea real y una pregunta cuya respuesta no esté en el documento.
- Desconecta la red para confirmar qué partes funcionan realmente offline.
- Registra modelo, tag, cuantización, contexto, velocidad y calidad para poder comparar.
Conclusión: elige por tarea y margen, no por hype
La elección robusta empieza por el trabajo que quieres hacer, continúa con la memoria realmente disponible y termina con una prueba repetible. Un modelo menor que responde rápido y supera tus casos es mejor producto que uno enorme que intercambia memoria con CPU o depende de la nube sin que lo hayas advertido. Cuando el flujo ya funcione, entonces tiene sentido comparar otra cuantización o subir de modelo.
Comparativa rápida
| Memoria útil | Punto de partida | Runtime | Uso razonable |
|---|---|---|---|
| 8-12 GB | Gemma 4 E2B/E4B, 3B-7B | Ollama o LM Studio | Chat, resumen y clasificación |
| 16 GB | Gemma 4 12B | Ollama, LM Studio o MLX | Documentos y trabajo diario |
| 24 GB | Qwen3.8-27B Q4, Muse Glimmer | Ollama o MLX | Código, visión y agentes supervisados |
| 32-48 GB | Qwen3.8-27B Q8, MoE cuantizados | llama.cpp, vLLM o SGLang | Más contexto y concurrencia |
| 96 GB+ | Modelos grandes cuantizados | Servidor especializado | Laboratorio y self-host avanzado |
Preguntas frecuentes
¿Cuál es el mejor modelo local en 2026?
No hay uno universal. Qwen3.8-27B es una opción potente para equipos con alrededor de 24 GB y margen suficiente; Gemma 4 ofrece variantes más pequeñas. El mejor es el que supera tus casos con velocidad y memoria aceptables.
¿Ollama o LM Studio?
Ollama encaja mejor al conectar APIs y agentes; LM Studio facilita explorar cuantizaciones y chatear con interfaz gráfica. Ambos pueden convivir.
¿Cuánta VRAM necesita Qwen3.8-27B?
El tag Q4_K_M de Ollama ocupa unos 18 GB, pero debes reservar memoria para contexto y runtime. Una GPU de 24 GB es un punto de partida más sensato que una de 16 GB.
¿La IA local es gratis?
Muchos runtimes y pesos no tienen coste de licencia, pero pagas hardware, electricidad, almacenamiento, mantenimiento y tiempo. Revisa además la licencia de cada modelo.
¿Un modelo cloud de Ollama funciona en local?
No. La aplicación puede invocarlo desde tu equipo, pero un tag cloud ejecuta la inferencia en servidores remotos. Revisa siempre el tag y la política de datos.
¿NVIDIA PAIR combina la memoria de varios PCs?
No. PAIR dirige cada solicitud a un único nodo; no suma VRAM ni divide un modelo o una petición entre varios equipos.
¿Puedo sustituir un modelo frontier cloud por uno local?
A menudo sí para correo, extracción, RAG y código cotidiano. Para razonamiento máximo o agentes largos puede convenir un enfoque híbrido: local por defecto y nube solo con datos y permisos controlados.
Fuentes consultadas
- Ollama · Qwen3.8 tags — Tamaños, cuantizaciones y contexto comprobados el 4 de septiembre de 2026.
- Ollama · Gemma 4 — Variantes edge, workstation y MLX.
- Ollama · Muse Glimmer — Modelo local multimodal de 30B y tags disponibles.
- Ollama · Nemotron 3.5 Lightning — Tamaños Q4, Q8, BF16 y MLX.
- Ollama · GLM-5.3-Flash — Actualmente ofrecido como tag cloud, no como descarga local.
- NVIDIA · Personal AI Router overview — Arquitectura, privacidad y modelo de enrutamiento por nodo.
- NVIDIA · PAIR technical announcement — Beta publicada el 3 de septiembre de 2026.
Sigue aprendiendo
Compara modelos grandes, routing y requisitos de privacidad.
Instala Ollama, Open WebUI y flujos privados paso a paso.
Diagnostica drivers, GPU híbrida, VRAM y procesos.
Compara capacidad, hardware y licencias de los lanzamientos recientes.